// artículo
Del prompt al context engineering: qué cambió
Saber escribir prompts dejó de ser la habilidad clave del desarrollo con IA. La gestión del contexto la sustituyó. Análisis de por qué y cómo.
En 2023, la habilidad más cotizada en el mundo de la IA generativa tenía un nombre que sonaba casi a broma: prompt engineering. Aparecieron cursos, ofertas de empleo con sueldos llamativos, hilos interminables sobre la instrucción perfecta. La promesa era que quien supiera formular la petición adecuada desbloquearía capacidades que a los demás se les escapaban. Durante un tiempo, fue parcialmente cierto.
En 2026, esa habilidad no ha desaparecido, pero ha quedado subsumida en algo más grande y más difícil: el context engineering. La frase que resume el cambio, y que se ha citado hasta el cansancio en el sector, es que la nueva habilidad en IA no es escribir prompts, sino diseñar contexto. Este artículo explica qué significa exactamente ese desplazamiento, por qué ocurrió, y qué implica para quien trabaja con estas herramientas a diario.
El techo del prompt#
El prompt engineering funcionaba bajo un supuesto: que el problema del modelo era de comunicación. Si el modelo daba una mala respuesta, era porque no habías sabido pedírsela bien. Reformula, añade ejemplos, especifica el formato, y la calidad sube. Para tareas de un solo turno y autocontenidas —resume este texto, traduce esta frase, genera este fragmento de código— el supuesto se sostenía razonablemente.
El problema es que ese supuesto tiene un techo bajo, y se alcanza rápido. Cuando las tareas se vuelven complejas, multi-paso o dependientes de información que el modelo no tiene, ajustar la redacción de la instrucción deja de mover la aguja. Puedes tener el prompt más elegante del mundo, pero si le pides a un modelo que razone sobre el estado de un sistema que no puede ver, o que use datos que no están en su ventana de contexto, ninguna floritura lingüística lo salvará.
La constatación clave fue esta: el modelo no fallaba por cómo le preguntabas. Fallaba por lo que no sabía en el momento de responder. Y eso no es un problema de redacción. Es un problema de información.
El giro hacia el contexto#
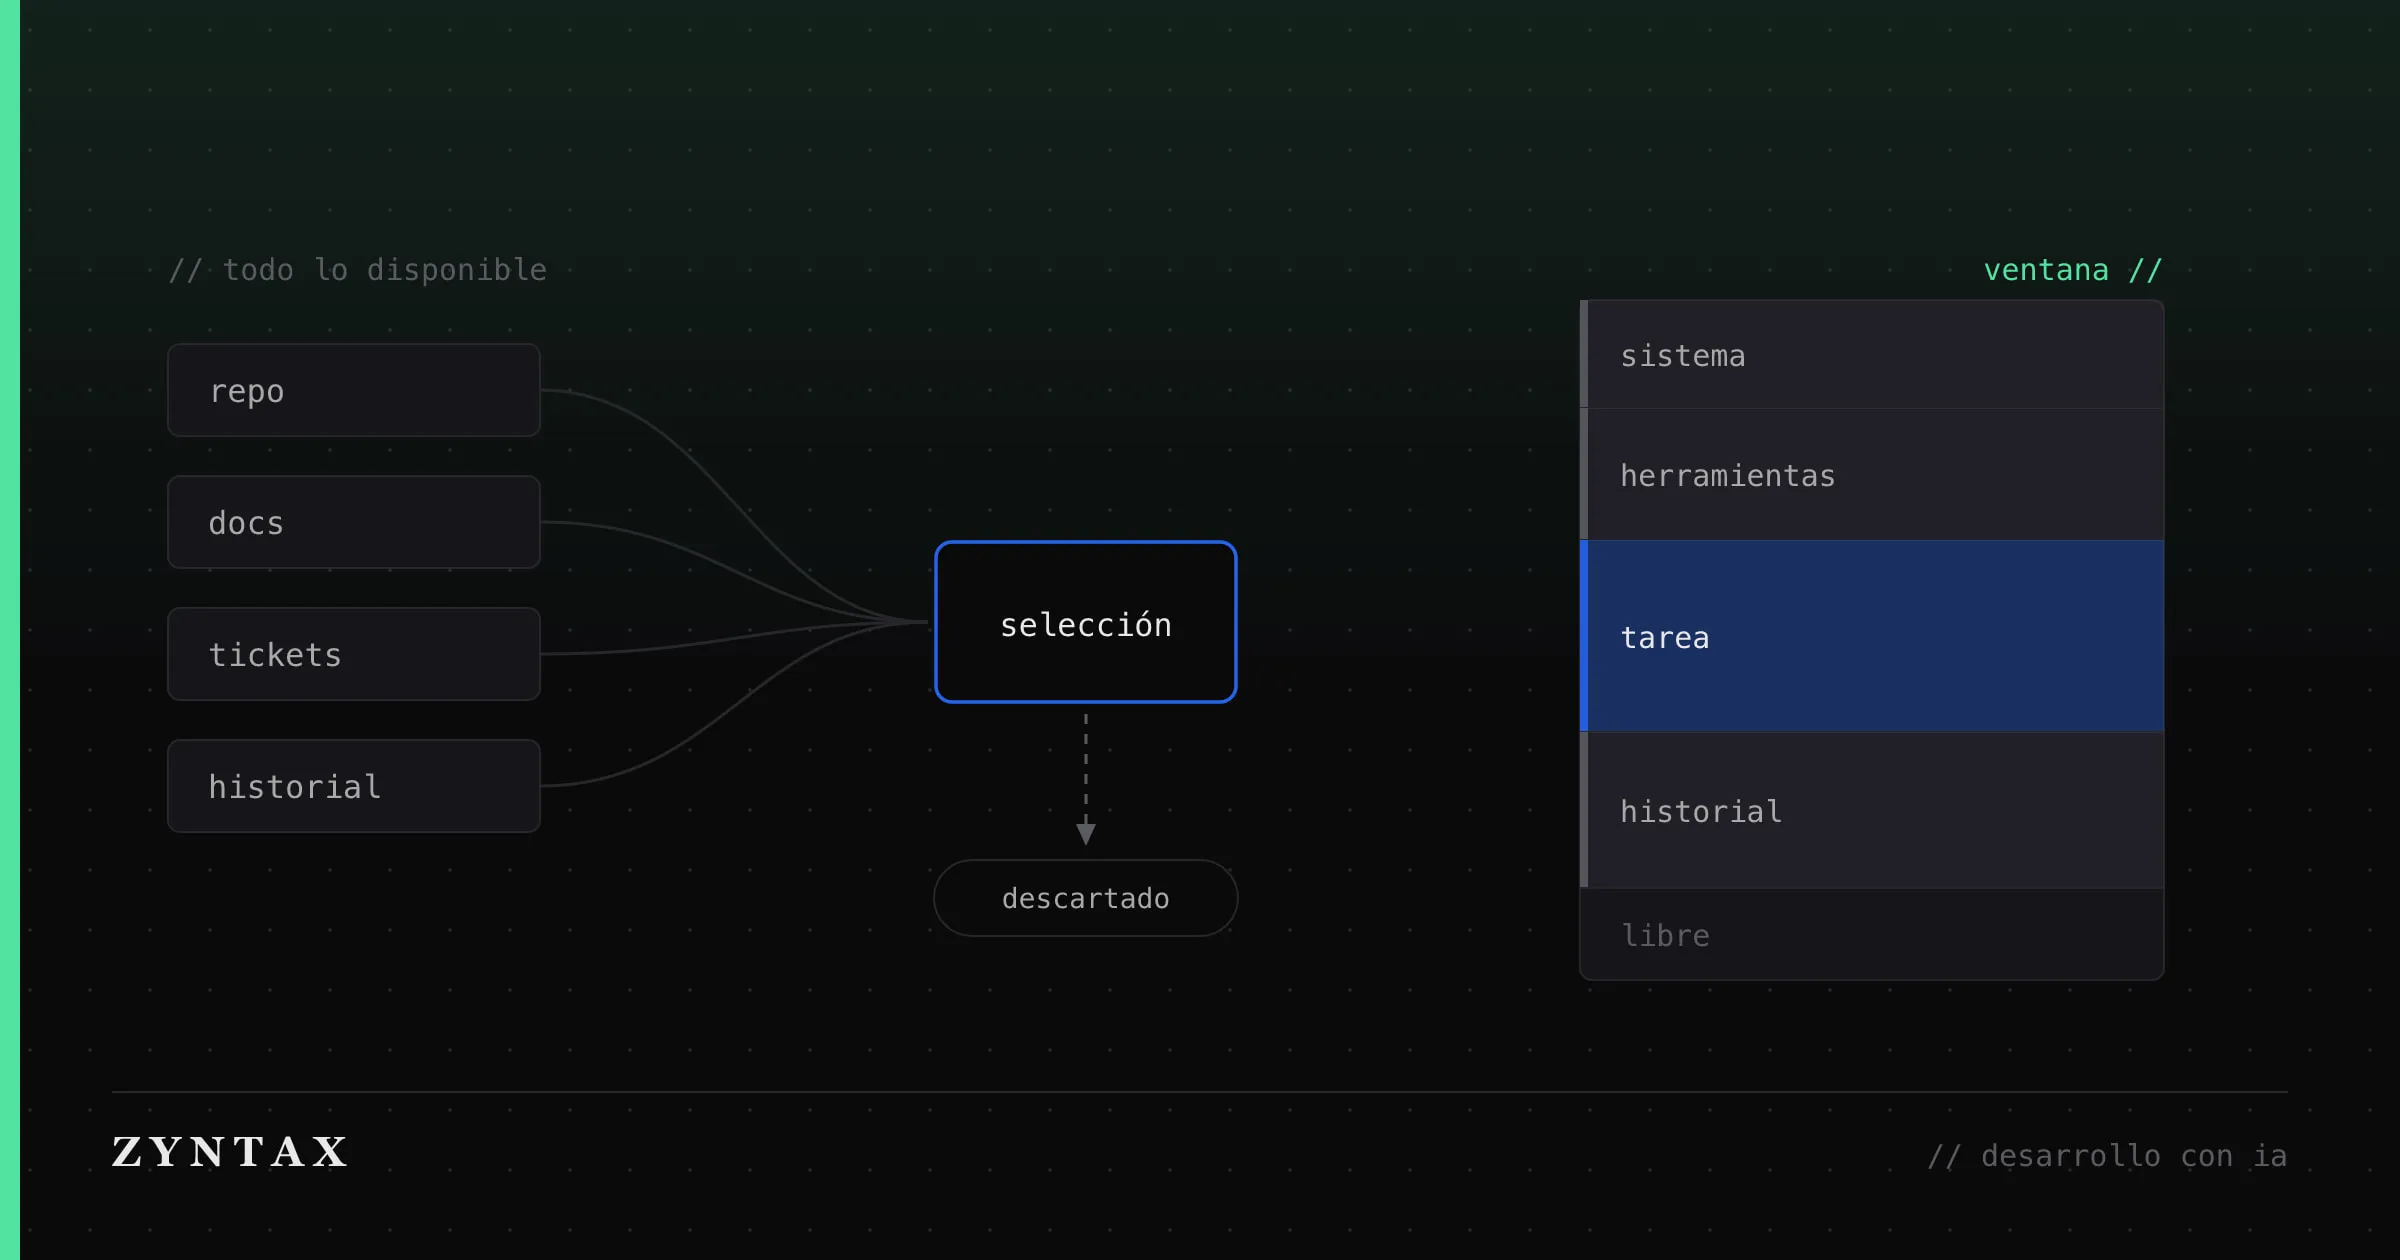
El context engineering reformula el problema. En lugar de preguntar “¿cómo redacto la instrucción?”, pregunta “¿qué información debería ver el modelo en cada paso para poder responder bien?”. Es un cambio de foco del input a la información, y trae consigo un conjunto de problemas de ingeniería mucho más ricos.
Gestionar el contexto significa tomar decisiones sobre varias cosas a la vez. Qué inyectar en cada turno: no todo lo que tienes disponible, sino lo relevante para el paso concreto que el modelo debe dar ahora. Cómo recuperar y comprimir la memoria: qué recuerdas de turnos anteriores, cómo lo resumes, qué descartas. Cómo rankear los resultados de las herramientas por relevancia: cuando el agente ha ejecutado varias acciones, cuáles de sus resultados merecen ocupar espacio en la ventana. Cómo manejar la saturación del contexto: qué haces cuando la información supera lo que cabe. Esta última decisión tiene nombre propio y artículo propio: qué se conserva y qué se descarta al compactar.
El alcance se expandió de un único input a la gestión de múltiples flujos de información que confluyen en la ventana de contexto. Esto es cualitativamente distinto de escribir un buen prompt. Es diseñar un sistema que decide, dinámicamente, qué ve el modelo en cada momento.
RAG y sus límites#
La primera gran herramienta del context engineering fue la generación aumentada por recuperación, más conocida por sus siglas en inglés, RAG. La idea es sencilla y potente: en lugar de esperar que el modelo lo sepa todo, le proporcionas en tiempo de ejecución los datos relevantes recuperados de una base de conocimiento. El modelo genera su respuesta apoyándose en esa información fresca e inyectada.
RAG resolvió problemas reales. Permitió que los modelos respondieran sobre documentación privada, datos actualizados o dominios específicos sin necesidad de reentrenarlos. Durante 2025 se convirtió en el patrón por defecto para casi cualquier aplicación seria con LLMs.
Pero RAG trajo su propio fallo característico, uno que quienes lo implementaron a fondo conocen bien: la ansiedad de contexto. Cuando inyectas cantidades masivas de texto sin filtrar en la ventana, el modelo se confunde. No porque el texto sea malo, sino porque hay demasiado y no todo es relevante. El modelo tiene que discernir la señal del ruido dentro de su propia ventana de contexto, y a menudo lo hace peor cuanto más le das. Más contexto no es siempre mejor contexto. A veces es directamente peor.
Esta constatación —que la calidad del contexto importa más que su cantidad— es lo que empujó la disciplina hacia enfoques más sofisticados de selección y compresión, y en última instancia hacia el harness engineering, donde la gestión del contexto se convierte en un componente más de una arquitectura mayor.
El caso del sistema de archivos#
Un ejemplo concreto ilustra hasta qué punto el context engineering maduró en 2026. El equipo de Microsoft que construyó su agente de SRE para Azure contó su experiencia al pasar de un enfoque a otro. Empezaron con más de cien herramientas hechas a medida y un prompt prescriptivo que intentaba anticipar cada situación. No funcionaba bien en incidentes nuevos.
El giro fue casi filosófico: en lugar de herramientas especializadas, expusieron todo —código fuente, runbooks, esquemas de consultas, notas de investigaciones previas— como archivos en un sistema de ficheros, y dejaron que el agente usara operaciones genéricas y familiares: leer un archivo, hacer grep, buscar, ejecutar comandos de shell. En vez de diseñar el contexto por adelantado con herramientas rígidas, dejaron que el agente navegara y construyera su propio contexto según lo necesitara.
El resultado fue una mejora sustancial en incidentes novedosos. La lección es profunda: a veces, el mejor context engineering no consiste en decidir por el modelo qué información necesita, sino en darle las herramientas para que él mismo encuentre y construya el contexto relevante. Es un cambio de “yo te doy exactamente lo que creo que necesitas” a “yo te doy acceso y capacidad de exploración”. Para muchos problemas, lo segundo escala mejor. Eso sí, dejar que el agente explore por su cuenta solo funciona dentro de un bucle con presupuestos y condiciones de parada; sin esos límites, la exploración libre se convierte en gasto libre.
Prompt engineering no ha muerto#
Sería un error concluir que redactar bien las instrucciones ya no importa. Sigue importando, pero ha cambiado de lugar en la jerarquía. El prompt sigue siendo la interfaz a través de la cual expresas la intención, las restricciones y el formato deseado. Un mal prompt sigue produciendo malos resultados. Lo que ha cambiado es que un buen prompt ya no es suficiente, y rara vez es el factor decisivo.
Una forma útil de verlo: el prompt engineering es ahora un subcomponente del context engineering, del mismo modo que el context engineering es un subcomponente del harness engineering. Cada disciplina no reemplaza a la anterior, la contiene. Escribes buenos prompts dentro de un sistema que gestiona bien el contexto, dentro de una arquitectura que orquesta bien la ejecución. Las tres capas coexisten; lo que cambia es dónde está el cuello de botella y, por tanto, dónde conviene invertir el esfuerzo. La capa de arriba es la arquitectura completa del harness, y es donde se ha movido la ventaja competitiva.
Qué habilidad merece la pena desarrollar#
Para un developer que quiera trabajar seriamente con IA en 2026, la pregunta práctica es en qué invertir el tiempo de aprendizaje. La respuesta, siguiendo la lógica de este artículo, es hacia arriba en la jerarquía.
Aprender a escribir prompts claros es el suelo, no el techo. Es necesario pero se domina relativamente rápido. El caso más cotidiano de context engineering para la mayoría de developers son los archivos CLAUDE.md y .cursorrules: contexto persistente que el modelo ve en cada turno sin que haya que repetirlo. Lo que de verdad distingue es entender la gestión del contexto: cómo diseñar qué ve el modelo, cómo recuperar información relevante sin saturar, cómo comprimir memoria a lo largo de una tarea, cuándo darle herramientas de exploración en lugar de contexto preempaquetado. Y por encima de eso, la arquitectura del harness completo.
Estas son habilidades de ingeniería de sistemas. Requieren pensar en flujos de información, en estado, en trade-offs entre precisión y coste. No se aprenden memorizando plantillas de prompts, sino construyendo sistemas y observando cómo fallan. Es un trabajo más difícil que la era del prompt, pero también más duradero: es mucho menos probable que se vuelva obsoleto con la siguiente versión del modelo, porque no depende de las peculiaridades de un modelo concreto, sino de principios de diseño que se mantienen.
El desplazamiento del prompt al contexto, y del contexto al harness, cuenta una misma historia desde tres ángulos: el valor en el desarrollo con IA se está moviendo desde lo que le dices al modelo hacia cómo diseñas el sistema que lo rodea. Quien siga optimizando la instrucción perfecta está puliendo una habilidad cuyo techo ya conocemos. Quien aprenda a diseñar contexto y arquitectura está construyendo sobre terreno que aguantará varias generaciones de modelos.